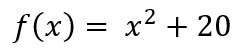วันอาทิตย์ที่ 29 มีนาคม พ.ศ. 2563

Genetic Algorithm#2


   สวัสดีครับหลังจากบทความที่แล้ว https://cakeknowledgeblogs.blogspot.com/2020/03/genetic-algorithm.html ได้พูดถึงทฤษฎีของอัลกอริทึมหนึ่งที่ชื่อว่า Genetic Algorithm วันนี้เราเลยจะนำความรู้มาใช้กันครับซึ่งเราจะนำความรู้มาแก้ปัญหา TSP(Traveling Salesman Problem) นั่นเอง

"แล้วปัญหา TSP(Traveling Salesman Problem) คืออะไร"

TSP(Traveling Salesman Problem) เป็นปัญหาสำหรับหาเส้นทางในการเดินทางไปยัง N สถานที่แล้วให้ได้ประโยชน์มากสุดเช่น เวลาที่สั้น หรือ ระยะทางที่สั้นที่สุดเป็นต้น

ตัวอย่างเช่น
เราต้องการไปทำบุญ 9 วัดซึ่งเรามีวัดในใจอยู่แล้ว แต่เราต้องการเดินทางไปทำบุญ 9 วัดโดยใช้ระยะทางทั้งหมดน้อยที่สุด ดังนั้นเราจะนำ Genetic Algorithm นี้แหละมาทำการจัดลำดับการเดินทางแล้วหวังว่าการเดินทางนั้นจะใช้เวลาที่น้อยที่สุดครับ


"แล้วเราจะเอา genetic algorithm มาใช้เพื่อแก้ปัญหา TSP อย่างไร?"


หลังจากที่เราได้เรียนรู้แล้วว่า genetic algorithm นั้น จะมีขั้นตอนหลักๆ คือ
1.         Initial population
2.         Fitness Function
3.         Selection
4.         Crossover
5.         Mutation
เราก็จะเอาขั้นตอนพวกนี้แหละมาดัดแปลงเพื่อแก้ปัญหา TSP(Traveling Salesman Problem) กันดังนี้

1. Initial population

   เราจะทำการสร้างคำตอบหลายคำตอบขึ้นมาก่อนซึ่งจะมีหน้าตาดังนี้

จากรูปจะเห็นว่าคำตอบของเราคือ การซุ่มลำดับของวัดที่เราจะเดินทางขึ้นมา และก็ทำการซุ่มอีกคำตอบเพื่อให้ได้หลายคำตอบ
จากคำตอบที่ 1 จะเห็นว่าจะมีการเดินทางดังนี้
จากบ้านไป วัดเอก, วัดจตุ, วัดสัตต , วัดโท , วัดตรี, วัดเบญจ, วัดนว ,วัดฉะ , วัดอัฎฐ, แล้วค่อยกลับมาบ้าน

(หมายเหตุชื่อวัดเป็นวัดที่คิดขึ้นมาเอง ดังนั้นอาจจะไม่มีชื่อวัดจริงบนโลก)

2. Fitness Function

   หลังจากนั้นเราก็มาทำการให้คะแนนคำตอบกันซึ่งการให้คะแนนนั้นจะให้คะแนนจากคนที่ใช้ระยะทางในการเดินทาง โดยคำตอบใหนใช้ระยะทางเดินทางสั้นก็จะได้คะแนนเยอะ ส่วนคำตอบใหนที่ใช้ระยะทางเยอะก็จะได้คแนนน้อยดังรูป

จากรูปจะเห็นว่าค่า fitness สำหรับปัญหา TSP TSP(Traveling Salesman Problem) เราจะใช้ 1/ระยะทางการเดินทางทั้งหมด เนื่องจากเราต้องการให้ระยะทางที่สั้นต้องได้คะแนนมากกว่าระยะทางที่ยาวนั่นเอง

3. Selection

   หลังจากเราให้ได้คะแนนของทุกคำตอบแล้วเราก็มาทำการเลือกคำตอบที่ดีที่สุดมา N จำนวนดังรูป โดยการเลือกคำตอบที่ดีที่สุดนั้นก็ดูจากค่า fitness ที่มากที่สุดมา N คำตอบนั่นเอง


4. Cross over

   หลังจากเราเลือกมาแล้วเราก็ทำการ Crossover กัน หรือก็คือการสร้างคำตอบขึ้นมาใหม่ที่เกิดจากการแลกคำตอบย่อยกันนั่นเองดังรูป


5. Mutation

   หลังจากที่เราได้คำตอบที่เกิดจาก Cross over มาใหม่แล้วเราก็อาจจะทำการสุ่มคำตอบย่อยมา เพื่อเปลี่ยนค่า โดยในที่นี้คือการสุ่มคำตอบย่อยมา 2 ตัวเพื่อมาสลับลำดับการเดินทางใหม่นั่นเอง


โดยขั้นตอนการทำงานของโปรแกรมนั้นก็จะทำ Initial population -> Fitness Function -> Selection -> Crossover -> Mutaion และก็เริ่มทำ Fitness Function ใหม่วนไปเรื่อยๆจนกระทั่งได้ระยะทางการเดินทางที่พอใจหรือระยะทางในแต่ละครั้งไม่ค่อยมีการเปลี่ยนแปลงนั่นเองครับ


ซึ่งหากใครสนใจอยากเขียนโปรแกรมการคำนวณ TSP(Traveling Salesman Problem) สามารถไปโหลดศึกษาดู code ได้ที https://github.com/CakeNuthep/GA_TSP โดยแอดได้เอาโคดต้นฉบับมากจาก https://github.com/7lb/TSP แล้วมาใส่คำอธิบายภาษาไทยไว้แล้วเพื่อให้สามารถเข้าใจได้เร็วขึ้น และสุดท้ายนี้หวังว่าโพสน์นี้จะมีประโยชน์นะครับ
ขอบคุณครับ


Refference


วันอังคารที่ 24 มีนาคม พ.ศ. 2563

Genetic Algorithm

   สวัสดีครับหลังจากห่างหายไปนาน เนื่องจากได้ไปศึกษา AI ตัวนึงที่มีอัลกอริทึมที่ชื่อว่า Genetic Algorithm ซึ่งเป็นแนวคิดที่ดี ซึ่งสามารถนำ Gentic Algorithm ไปประยุกต์ในการแก้ปัญหาหลายๆอย่างดังลิงค์นี้ครับ https://en.wikipedia.org/wiki/List_of_genetic_algorithm_applications ซึ่งจะเห็นว่ามีหลายแอพพลิเคชันเลยที่นำไปใช้

"แล้ว Genetic Algorithm คืออะไร?"
   Genetic Algorithm ก็คือขั้นตอนการแก้ปัญหาบางอย่างโดยเลียนแบบกระบวนการถ่ายทอดทางพันธุกรรม

"แล้วทำไม่ต้องเลียนแบบการถ่ายถอดทางพันธุกรรม?"

  เนื่องจากเราสังเกตุว่าสิ่งมีชีวิตที่อยู่รอดปัจจุบันนั้นเกิดจากการวิวัฒนาการให้เข้ากับสภาพแวดล้อมให้เหมาะสม โดยการวิวัฒนาการของสิ่งมีชีวิตนั้นก็คือ การสืบพันธ์เพื่อให้รุ่นลูกมีสภาพที่ทนต่อสภาพแวดล้อม หรืออาจเกิดจากการกลายพันธ์ รุ่น สู่ รุ่น ไปเรื่อยๆ จนทำให้สิ่งมีชีวิตใหม่ที่ปรับตัวได้เหมาะสมก็จะเป็นผู้อยู่รอดนั่นเอง จึงได้เกิดแนวคิดในการเขียนโปรแกรมเพื่อหาคำตอบของปัญหาโดยให้เปรียบเทียบคำตอบนั้นเหมือนกับสิ่งมีชีวิตแล้วคำตอบนั้นสามารถปรับแก้ไขได้โดยการสืบทอด หรือ การกลายพันธ์จนได้คำตอบที่เหมาะสมกับปัญหามากที่สุดนั่นเอง

"แล้ววิวัฒนาการกับการเขียนโคดมันจะเขียนยังไง?"

   ในการที่จะเขียนโคดเพื่อเลียนแบบการวิวัฒนาการของสิ่งมีชีวิตนั้นเราจะมองลึกลงไปอีก ของการวิวัฒนาการนั่นก็คือ Chromosome เพราะสิ่งมีชีวิตที่เกิดการกลายพัน หรือลูกที่เกิดจากการสืบพันธ์นั้นเกิดจาก การทำให้ Chromosome มีการเปลี่ยนแปลงกันทั้งสิ้นดังนั้นในการเขียน Code เราจำเป็นที่จะให้คำตอบในการแก้ปัญหานั้นเปรียบเทียบคล้ายกับ Chromosome นั่นเอง ซึ่งก่อนที่จะเริ่มเขียนโคดกันเรามาทำความเข้าใจของการวิวัฒนาการเมื่อมองในมุมมองของ Chromosome ซึ่งในการวิวัฒนาการนั้นจะมีขั้นตอนดังนี้
  1. การคัดสรร  คือการเลือก Chromosome ที่เหมาะสมกับธรรมชาติมากที่สุด ส่วน Chromosome ใหนที่ไม่เหมาะสมก็จะตายไป


ดังรูปจะเห็นว่า สิ่งมีชีวิตที่มี Chromosome1, Chromosome2, Chromosome4 จะถูกเลือกให้อยู่รอด ส่วนสิ่งมีชีวิตที่มี Chromosome3 จะตายไป เนื่องจาก Chromosome1, Chromosome2, Chromosome4 มีค่าความเร็วและความแข็งแรงมากกว่า Chromosome3
  2. การสืบพันธ์  คือการสืบพันธ์เพื่อให้ได้ Chromosome ตัวใหม่และหวังว่า Chromosome ตัวใหม่นั้นจะดีกว่าเดิม


ดังรูปจะเห็นว่า สิ่งมีชีวิตที่มี Chromosome1, Chromosom2 ได้ทำการสืบพันธ์กัน และได้ลูกมา 2 ตัวหรือก็คือ Chromosome5, Chromosome6 ซึ่งจะเห็นว่า Chromosome5, กับ Chromsome6 เกิดจากการแลกเปลี่ยนบางพันธุกรรมใน Chromosome1 กับ Chromosome2 จนทำให้เกิด Chromome5, กับ Chromome6 นั่นเอง
  3. การกลายพันธ์  คือ การทำให้ Chromosome มีการเปลี่ยนเปลงข้อมูลบางจุด


ดังรูปจะเห็นว่า chromosome5 เกิดการกลายพันธ์จนทำให้ค่าความเร็วมีค่ามากขึ้นกว่าของแม่และของพ่อ(นั่นก็คือ Chromosome1 กับ Chromosome2) นั่นเอง

"แล้วตกลงจะมาเขียนโคดยังไง?"

ในการเขียนโคดก็เอาขั้นตอนวิวัฒนาการดังกล่าวนี่แหละมาเขียนโคดซึ่งจะมีขั้นตอนดังนี้
1. Initial population
2. Fitness Function
3. Selection
4. Crossover
5. Mutation

1. Initial population
ในตอนเริ่มต้นจำเป็นจะต้องสร้าง Chromosome หลาย Chromosome ขึ้นมาซึ่ง สิ่งที่เรียกหลายๆ Chromsome ทั้งหมดนี้เราจะเรียกว่า ประชากรดังรูป


โดยข้างใน Chromosome ก็จะมีคำตอบอยู่แล้ว ซึ่งคำตอบเหล่านั้นเป็นคำตอบที่เกิดจากการมั่วทั้งหมดซึ่งอาจทำให้มีทั้งคำตอบที่ผิดมาก มีทั้งที่ผิดน้อย หรือใกล้เคียงกับความถูกต้องมากที่สุด เป็นต้น

2.Fitness Function
เมื่อเรามี Chromosome หลายๆตัวและแต่ละ Chromosome ก็จะมีคำตอบที่แตกต่างกัน ดังนั้นเราจำเป็นที่จะต้องมีการตรวจคำตอบว่า Chromosome แต่ละตัวให้คำตอบที่ใกล้เคียงกับความถูกต้องมากสุดเท่าไหร่ หรือก็คือเราจะทำการให้คะแนนของคำตอบแต่ละ Chromosome นั่นเองว่า คำตอบดีหรือไม่ ถ้าคำตอบดีหรือถูกต้องก็ได้คะแนนเยอะ ถ้าคำตอบไม่ดีหรือไม่ถูกต้องก็ใด้คะแนนน้อยเป็นต้น


3. Selection
คือการเลียนแบบการคัดสรรธรรมชาติโดยเลือกเอากลุ่ม Chromosome ที่ดีที่สุดมา N ลำดับซึ่งเราจะรู้ได้อย่างไรว่า Chromosome ใหนดีไม่ดีสามารถดูได้จากการใข้ Fitness Function จากข้อ 2 นั่นเอง


4. Crossover
ถ้าให้เปรียบเทียบจะคล้ายๆกับการสืบพันธ์ โดยทำการแลกเปลี่ยนข้อมูลระหว่าง 2 Chromosome(Chromosome ของพ่อแม่) จนเกิด Chromosome ใหม่ 2 Chromosome (Chromosome ของลูก)


จากรูปจะเห็นว่า Chromosome3 กับ Chromosome4 มาทำการ Crossover กัน จนเกิด Chromosome ใหม่ขึ้นมา 2 ตัวที่ชื่อว่า Chromosome5 กับ Chromosome6 ที่เกิดจากการสลับข้อมูลระหว่างคำตอบย่อยที่1 กับคำตอบย่อยที่2 หรือถ้าให้เปรียบเทียบก็เหมือนกับเราลอกคำตอบกับเพื่อนสองคนสลับข้อกันและหวังว่าจะทำให้เราถูกมากขึ้นนั่นเอง

5. Mutation
คือการกลายพันธ์ของ Chromosome โดยเกิดจากการสุ่มเปลี่ยนค่าบางค่าในข้อมูลของ Chromosome


ดังรูปจะเห็นว่าหลังจากที่เราทำการ Crossover จากข้อ 4 แล้วเราก็ทำการกลายพันธ์โดยการเลือก คำตอบย่อยที่2 มาเปลียนค่านั้นเอง
ถ้าให้เปรียบเทียบก็เหมือนกับเราเอาคำตอบย่อยมาบางข้อแล้วมามั่วคำตอบใหม่และหวังว่าหลังจากมั่วคำตอบแล้วจะทำให้คะแนนเพิ่มขึ้นนั่นเอง

6. Termination
คือการหาคำตอบที่เหมาะสมกับปัญหา โดยอาจจะดูค่า Fitness แล้วผลที่ได้จาก Fitness ตรงตามที่เราต้องการ หรืออาจจะเป็นค่า Fitness ในรุ่นลูกถัดไปเรื่อยๆไม่ค่อยมีการเปลี่ยนแปลง


โดยลำดับในการทำงานของ Genetic Algorithm นั้นจะเป็นดังนี้ครับ


จะเห็นว่าตอนแรกสุดจะทำการ Initial population ขึ้นมาจำนวนนึงเสร็จแล้วก็จะทำการคัดสรร(selector) เพื่อนำไป Crossover หลังจาก Crossover แล้วอาจจะมีการ Mutation ของข้อมูลเกิดขึ้น แล้วเราก็ทำการคัดสรรอีก(selector) วนไปเรื่อยๆจนกว่าเราได้ Chromosome หรือคำตอบที่เราพอใจ ก็จะทำการ Termination นั่นเองครับ

ถ้าให้เปรียบเทียบก็เหมือนกับเรานำคำตอบที่เกิดจากการมั่วขึ้นมา N คำตอบ (Initial population) เสร็จแล้วเราก็มาตรวจคำตอบที่เกิดจากการมั่วนี่แหละว่าใครได้มากใครได้น้อย เสร็จแล้วเราก็เอาคำตอบของพวกที่ได้คะแนนมาก(selector)มาสลับคำตอบข้อย่อยกัน(Crossover) เพื่อหวังว่าคำตอบใหม่ที่เกิดจากการสลับไปนั้นจะทำให้ได้คะแนนที่เพิ่มขึ้น และบางครั้งอาจจะลองเลือกข้อย่อยมามั่วเอง(Mutation) เพื่อหวังว่าข้อที่มั่วจะเป็นตัวที่ได้คะแนนมากกว่าคนอื่น หลังจากนั้นเราก็มาตรวจคำตอบว่าใครได้มากใครได้น้อย เสร็จแล้วเราก็เอาคำตอบของพวกที่ได้คะแนนมาก(selector) มาสลับคำตอบข้อย่อยกัน(Crossover) เพื่อหวังว่าคำตอบใหม่ที่เกิดจากการสลับไปนั้นจะทำให้ได้คะแนนที่เพิ่มขึ้น และบางครั้งอาจจะลองเลือกข้อย่อยมามั่วเอง(Mutation)เพื่อหวังว่าข้อที่มั่วจะเป็นตัวที่ได้คะแนนมากกว่าคนอื่น ทำแบบนี้วนไปเรื่อยๆจนกระทั้งได้คะแนนที่พอใจนั่นเอง(Termination)

สุดท้ายนี้หวังว่าบทความนี้จะช่วยเพิ่มความเข้าใจในการทำ Genetic Algorithm มากขึ้นและบทต่อไปเราจะนำความรู้เรื่อง Genetic Algorithm มาแก้ปัญหาในการจัดสถานที่เดินทางโดยใช้ระยะทางเดินทางที่น้อยที่สุดกันครับ ตัวอย่างเช่น เราต้องการไปทำบุญ 9 วัดซึ่งเรามีวัดในใจอยู่แล้ว ซึ่งเราต้องการเดินทางไปทำบุญ 9 วัดโดยใช้ระยะทางทั้งหมดน้อยที่สุด ดังนั้นเราจะนำ Genetic Algorithm นี้แหละมาทำการจัดลำดับการเดินทางแล้วหวังว่าการเดินทางนั้นจะใช้เวลาที่น้อยที่สุดครับ

แล้วพบกันใหม่ในบทความถัดไปครับ Genetic Algorithm2😊

Refference
- https://towardsdatascience.com/introduction-to-genetic-algorithms-including-example-code-e396e98d8bf3
- https://lukkiddd.com/genetic-algorithm-พันธุกรรมมหัศจรรย์-6314fc9afca5

วันอาทิตย์ที่ 12 มกราคม พ.ศ. 2563

Web scraping


สวัสดีครับวันนี้จะมาแชร์เรื่อง Web scraping 

 "แล้ว Web Scraping คืออะไร ?"

   Web Scraping คือการดึงข้อมูลที่สนใจจากเว็บไซต์โดยตรง  ยกตัวอย่างเช่น เราต้องการดึงข้อมูลจากเว็บไซต์ https://www.oceannetworks.ca/news/stories โดยข้อมูลที่เราสนใจคือ หัวข้อที่มีคำว่า Real-Time หรือ Expedition และ ลิงค์ URL ที่ไปหัวข้อนั้น ตามรูปครับ

รูปภาพที่1 เว็บไซต์ที่ต้องการ Scraping


รูปภาพที่2 ข้อมูลที่ต้องการจากเว็บไซต์


" แล้ว Web scraping ทำงานอย่างไร ? "

 ในการทำเว็บไซต์นั้นจะเขียนเว็บโดยใช้ภาษา HTML ดังนั้นสิ่งที่ web scraping ทำก็คือไปอ่านภาษา HTML ในหน้าเว็บดังกล่าวเพื่อดึงข้อมูลกลับมาดังรูป (หากใช้ Chrome สามารถดู sourde code โดยการคลิกขวาที่เว็บไซต์แล้วเลือก Inspect)

รูปที่3 การเข้าไปดู HTML


รูปภาพที่4 HTML ของเว็บไซต์

แต่ในการเลือกว่าจะดึงข้อมูลเฉพาะตรงหัวข้อเท่านั้น เราจำเป็นที่จะต้องรู้รูปแบบ HTML ของเว็บดังกล่าวว่า HTML เป็นอย่างไร

รูปภาพที่5 รูปแบบ HTML
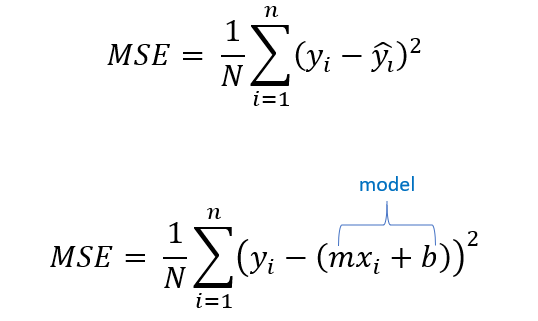

จากรูปภาพที่5 จะเห็นว่าหัวข้อที่เราสนใจนั้นจะอยู่ข้างล่างคำว่า  <div class="views-field views-field-nothing">
หรืออาจจะกล่าวได้ว่าหัวข้อนั้นจะอยู่ภายใต้ Class ที่ชื่อว่า views-field และ views-field-nothing นั่นเองเราก็สามารถเขียนโปรแกรมให้ดูหัวข้อเฉพาะใน Class ที่ชื่อว่า views-field และ views-field-nothing แล้วดึงข้อความมาได้ครับ

หากอยากรู้ว่า "แล้วจะเขียนโปรแกรมให้สามารถดึงข้อมูลดังที่กล่าวมาอย่างไร" สามารถดูวิธีการเขียนได้ที่
https://dev.to/rachelsoderberg/create-a-simple-web-scraper-in-c-1l1m?fbclid=IwAR3kEtA4JDukJ6S-47T3RkELXAcnZBM4x0dfJ3DfXOvad9BAwDRRkVNFwaE
และดู Source Code ได้ที่ https://github.com/CakeNuthep/Web-Scraper-C- ครับ

สุดท้ายนี้หวังว่าบทความนี้จะเป็นประโยชน์ต่อผู้ที่มาอ่านนะครับ
ขอบคุณที่อ่านครับ

วันอาทิตย์ที่ 22 ธันวาคม พ.ศ. 2562

ASR


"แล้ว ASR คืออะไร"
   ASR ย่อมาจาก Automatic Speech Recognition หรือเรียกภาษาไทยว่า เทคโนโลยีรู้จำด้วยเสียง
เพื่อให้คอมพิวเตอร์เข้าใจว่าที่เราพูดไปนั้นคือคำว่าอะไรนั่นเอง ตัวอย่างตามวีดีโอด้านล่างครับ


จากวีดีโอจะเห็นว่าจะเป็นการทำ ASR เพื่อให้คอมพิวเตอร์เข้าใจว่าถ้าพูดว่า "โดด" คอมจะเข้าใจว่าโอเคให้ ไดโนเสาร์กระโดด แต่ถ้าพูดว่า "หมอบ" คอมจะเข้าใจว่าให้ไดโนเสาร์หมอบ ซึ่งจะเห็นว่าในขั้นตอนการทำนั้นจำเป็นทีจะต้อง Train คอมให้เข้าใจคำว่าโดด กับหมอบก่อน โดยในตัวอย่างวีดีโอจะทำการนำไฟล์เสียงหมอบและไฟล์เสียงโดดทำการ Train ด้วย Model ที่ชื่อว่า Hidden Markov Model
เพื่อทำการรู้จำเสียง ซึ่งหากใครสนใจโคดหรือหลักการทำงานสามารถโหลดได้ดังนี้ครับ

Source code link: https://github.com/CakeNuthep/ASR-COMMAND

หลักการทำงาน
จะเป็นวีดีโอการสอนของอาจารย์ที่จุฬาลงกรณ์มหาวิทยาลัย ดังนี้ครับ

2110432 ASR L1 Introduction


2110432 ASR L2 Speech Signal Fundamentals I


2110432 ASR L3 Speech Signal Fundamentals II


2110432 ASR L4 Speech Production


2110432 ASR L5 Spectrogram Analysis 1


2110432 ASR L6 Spectrogram Analysis 2


2110432 ASR L7 AM Part I (feature extraction and DTW)


2110432 ASR L8 AM Part II (HMM) and LM


2110432 ASR L9-1 Docker tutorial


2110432 ASR L9-2 Class and Topic Language models, Lexicon


2110432 ASR L10 FST, Decoder, and Kaldi Demo


2110432 ASR L11 Deep learning and ASR


2110432 ASR L12 Various topics in ASR (CTC, VAD, Noise robustness, Speaker recognition)


วันอาทิตย์ที่ 20 ตุลาคม พ.ศ. 2562

Learning Rate

สวัสดีครับ หลังจากบทความที่แล้วได้แชร์เรื่อง Machine learning ในการทำ Simple Linear regression กันไปแล้ว และเห็นว่าจะเจอศัพท์คำนึงที่ชื่อว่า Learning rate วันนี้เลยจะมาทำความเข้าใจคำว่า Learning Rate กันครับ


"Learning Rae คืออะไร ?"

    Learning Rate คือค่าหนึ่งไว้สำหรับกำหนดอัตราการเรียนรู้ของ Machine Learning ซึ่งยิ่งค่า Learning Rate ยิ่งมีค่ามาก Machine learning ก็เรียนรู้ได้ไวดังรูป


ค่า Learning Rate สูง

ค่า Learning Rate ต่ำ


"แสดงว่าเราควรตั้งค่า Learning Rate ยิ่งสูงยิ่งดี 
เนื่องจากจะทำให้ Machin Learning เรียนรู้ไวใช่ใหม ?"

    ในการกำหนดค่า Learning Rate นั้นควรกำหนดให้เหมาะสม มากไปก็ไม่ดี ค่าน้อยไปก็ทำให้ Machine Learning เรียนรู้ได้ช้าและใช้เวลานาน


"แล้วทำไมค่า Learning Rate สูงไปไม่ดี ?"

    ลองจินตนาการว่า Learning Rate คือการปรับว่า จะให้ Model ที่ปรับใหม่มีการเปลี่ยนแปลงมากหรือน้อย ซึ่งถ้าเป็น Model ของ Simple Linear Regression ก็จะหมายถึงการให้ปรับเส้น Linear มีการเปลี่ยนแปลงแต่ละครั้งมากหรือน้อยดังรูป

ค่า Learning Rate สูง ทำให้เปลี่ยนแปลงเส้นแต่ละครั้งสูง

ค่า Learning Rate ต่ำ ทำให้เส้นที่ปรับใหม่เปลี่ยนแปลงแต่ละครั้งน้อย


    ดังนั้นถ้าสังเกตุดีๆ ถ้าเรากำหนดค่า Learning Rate มากไปก็อาจจะทำให้ เส้น Linear ที่ปรับได้ไม่เข้าใกล้ค่าความเป็นจริง เนื่องจากปรับ Linear แล้วค่าข้ามเกินความเป็นจริงไปดังรูป

สมมุติค่า Learning Rate = 0.1 ( ค่า learning rate สูงไป)


สมมุติค่า Learning Rate = 0.01 (ค่า Learning Rate เหมาะสม)

สมมุติค่า Learning Rate = 0.00001 (ค่า Learning Rate ต่ำไป)


จากรูปจะเห็นว่า Learning Rate เป็น 0.1 จะทำให้ค่าที่ได้ไม่เข้าใกล้ความเป็นจริงเนื่องจาก มีการปรับ Learning Rate สูงไปจึงทำให้การปรับเส้นตรงแต่ละครั้ง เลยค่าความเป็นจริงนั่นเอง


สุดท้ายนี้หวังว่าโพสน์นี้จะมีประโยชน์นะครับ

วันศุกร์ที่ 11 ตุลาคม พ.ศ. 2562

Simple Linear Regression#2

      สวัสดีครับหลังจากสัปดาห์ที่แล้วเราได้แชร์เรื่องหลักการของการทำ Simple Linear Regression โดยใช้ Machine learning กันไปแล้ว (http://cakeknowledgeblogs.blogspot.com/2019/09/simple-linear-regression.html) วันนี้จะมาเจาะลึกถึงคณิตศาสตร์จนกระทั้งสามารถนำไปประยุกต์เขียน Code ด้วยตัวเองครับ งั้นมาเริ่มกันเลยครับ

สมมุติเรามีข้อมูลของราคาการเช่าหอแต่ละเดือนในกรุงเทพเมื่อเปรียบเทียบกับพื้นที่ห้องดังนี้


พื้นที่ (m2)
ค่าเช่าหอต่อเดือน (บาท)
22.5
2100
24
2800
26
3250
26.5
3600
30
3800
32
4300
34.5
4600
36.5
5000
38
5800
42
7000

ซึ่งเราต้องการนำข้อมูลที่ได้ไปวาดกราฟ ดังนี้ครับ


สิ่งที่เราต้องการนำ ML มาช่วยคือการหา Model ซึ่งในรูปแบบของ Simple Linear regression นั้นก็คือ เส้นแนวโน้มดังนี้ครับ

          ดังนั้น Model ในที่นี้จะเป็นการหาเส้นแนวโน้มจากเส้นสีแดงข้างบน เพื่อไว้ใช้สำหรับทำนาย (Predict) ข้อมูล ตัวอย่างเช่น เราต้องการอยากรู้ว่าถ้าขนาดห้อง 40 ตารางเมตร เราสามารถนำ Model ที่หาได้ มาทำนาย (Predict) ดังนี้ครับ
จากรูปด้านบนจะเห็นว่าที่พื้นที่ห้องขนาด 40 ตารางเมตรจะมีราคาหอต่อเดือนประมาณ 6000 กว่าบาทเมื่อเปรียบเทียบกับ Model (ในที่นี้คือเส้นแนวโน้มสีแดง)


“แล้วจะให้คอมพิวเตอร์เข้าใจ Model (ในที่นี้คือเส้นแนวโน้ม) อย่างไร?”

Model ในทางคอมพิวเตอร์เป็นสมการหนึ่ง
สมการ Model ใน Simple linear Regression นั้นก็คือเส้นแนวโน้มที่เป็นเส้นตรง ซึ่งเราสามารถสร้างเป็นสมการเส้นตรงได้ดังนี้ครับ
y = mx+b

และถ้าดูจากเส้นแนวโน้มดังรูปเราสามารถสร้างเป็นสมการเส้นตรงได้ป็น


y= 219x-2607.7
หมายความว่าค่า m = 219 , b = -2607.7

หลังจากเราได้ Model เป็นสมการ
y= 219x-2607.7

เราสามารถนำ Model มาทำนายได้แล้วครับ

สมมุติเราต้องการหาราคาหอเมื่อมีขนาดพื้นที่ 40 ตารางเมตร เราสามารถหาได้โดยการนำไปเข้าสมการดังนี้ครับ
y = 219(40)-2607.7 = 6152.3 
จะเห็นว่าจะได้ราคาประมาณ 6000 กว่าบาทหรือนั่นก็คือ 6152.3 บาท

“แล้วเราจะหาค่า m และ b ในสมการ y=mx+b อย่างไร?”
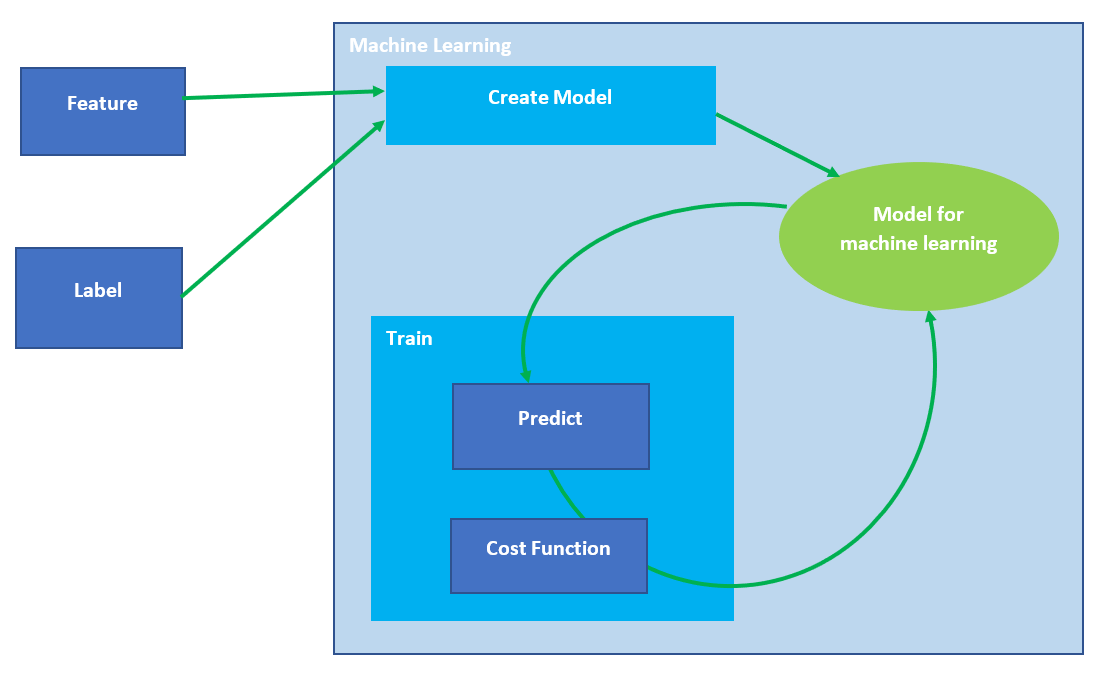
ในการหา m และ b นั้นเราจะใช้ Machine learning ในการหาโดยมีขั้นตอนการทำงานดังรูป


·                จากรูปหลักการทำงานด้านบนเราจะนำข้อมูลที่เรามีอยู่แล้ว(Feature)และรู้ผลลัพธ์อยู่แล้ว(Label)ให้ Machine learning ทำการเรียนรู้
·                โดยในการเรียนรู้นั้นตอนแรก ML จะสร้าง Model ขึ้นมาก่อนซึ่ง Model ดังกล่าวยังไม่สามารถทำนายข้อมูลได้ถูกต้อง
·                จึงต้องเข้าสู่กระบวนการ Train ข้อมูลเพื่อทำการปรับ Model ให้ถูกต้องมากที่สุดโดยกระบวนการ Train จะทำงานโดยการนำ Model มาทำนายผลจากข้อมูล(Feature)
·                ซึ่งก็จะมีทั้งการทำนายที่คลาดเคลื่อนกับความเป็นจริงไปมาก หรือใกล้ความเป็นจริง (ในการดูข้อมูลว่าผลทำนายที่ได้คลาดเคลื่อนไปมากหรือใกล้ความเป็นจริงเราใช้ Cost Function ในการดู)
·                ก็นำเอาค่าความเคลื่อนที่ได้ ไปปรับ Model เข้าหาผลลัพธ์ที่ถูกต้อง
·                หลังจากนั้นจะทำการ Train ไปเรื่อยๆและปรับค่า Model ไปเรื่อยๆ
จนใกล้เคียงข้อมูลจริงมากที่สุด


“Cost Function คืออะไร?”
จากขั้นตอนการทำงานของ Machine learning จะเห็นว่าจะมีการเข้า Cost Function แล้ว Cost Function คืออะไร

Cost Function คือ สมการในการหาค่าความ Error ของ Model ที่ใช้ในการทำนาย(Predict) ซึ่งค่า Cost Function ยิ่งมีค่ามากแสดงว่า Model ที่ใช้ในการทำนาย(Predict) ยิ่งมีความ Error มาก
ในสมการ Cost Function จะมีหลากหลายสมการที่ใช้ในการคำนวณหาค่า Error ซึ่งในที่นี้เราจะใช้สมการที่เรียกว่า Mean Squared Error (MSE) โดยมีสมการดังนี้
หรือมองเป็นรูปภาพได้ดังนี้ครับ


“แล้วเราจะไปปรับค่า Model อย่างไร?”

เนื่องจาก Model เราคือสมการเส้นตรง y=mx+b ดังนั้นเราสามารถปรับค่า m และ b เพื่อให้ได้ค่า Cost Function ที่น้อยที่สุดที่เป็นไปได้


“แล้วเราจะรู้ได้อย่างไรว่าควรปรับค่า m เท่าไหร่ ปรับค่า b เท่าไหร่”
ในการปรับค่า m ค่า b เราจะพิจราณาจาก Gradient Descent Derivation ในการปรับค่า m และ ค่า b โดยหลักการ Gradient Descent เป็นดังนี้ครับ

Gradient Descent คือ การหา Slop ที่ไล่ลงมารื่อยๆ จากรูปด้านล่างดังนึ้ครับ


จากรูปจะเห็นว่าเป็น รูประฆังหงาย ที่เกิดจากการนำเอาค่า Cost Function ที่เราปรับ Model มาหลายๆครั้งมาคำนวณค่า Cost Function แล้วเอามา Plot จะเกิดเป็นรูประฆังหงายดังรูป โดยค่าที่อยู่ก้นระฆังนั้นจะหมายความว่าค่า Cost Function มีค่าเท่ากับ 0 หรือหมายความว่า model ที่ใช้ในการคำนวณนั้นมีความคลาดเคลื่อนจากข้อมูลจริงเป็น 0 หรือมีความแม่นยำมากๆในการทำนาย ดังนั้นจึงสรุปได้ว่า ถ้าค่า Cost function ยิ่งอยู่บริเวณก้นระฆังมากเท่าไหร่แสดงว่า Model นั้นย่อมมีความแม่นยำมาก

“แล้วเราจะรู้ได้อย่างไรว่าจะปรับค่า m และ b ในสมการ y=mx+b เท่า

ไหร่บ้าง”

เราจะดูค่า แนวโน้มว่า m และ b ควรปรับเพิ่มขึ้นหรือปรับลดลงโดยดูจากความชันของจุดข้อมูลที่เราทำการ Train แต่ละครั้ง

“แล้วเราจะดูความชันอย่างไร”

เราจะใช้คณิตศาสตร์ Calculus ในเรื่องของการหาอนุพันธ์(derivative) นั่นเอง โดยการหาอนุพันธ์ (derivative) ของฟังก์ชันใดๆ จะได้สมการความชันของฟังก์ชันนั้นๆ

ยกตัวอย่างการหาอนุพันธ์

สมมุติเรามีสมการ
หรืออาจจะเขียนใหม่ได้ว่า
ซึ่งสามารถนำสมการมาวาดกราฟได้ดังนี้


ทำการอนุพันธ์สมการ

จะได้


จะเห็นว่าสมการ
จะเป็นสมการที่บอกความชัน ณ จุดใดๆ ของสมการ
เช่นเราต้องการรู้ความชัน ที่ x = -5  เราก็เอาค่า x ไปแทนในสมการ

ซึ่งค่าความชันที่ได้เป็น -10 ดังรูป

หรือหากเราต้องการจะรู้ความชันที่ x=5 เราเอาค่า x ไปแทนในสมการ
ค่าความชันที่ได้เป็น 10 ดังรูป

จากตัวอย่างจะเห็นว่า การหาอนุพันธ์ จะได้สมการที่บอกความชันของแต่ละจุดซึ่งความชันที่ได้จะมีค่า เป็นจำนวนเต็มบวก หรือจำนวนเต็มลบ
โดย
ค่าเป็นจำนวนเต็มลบ จะหมายถึงกราฟมีความลาดชันลง
 ค่าเป็นจำนวนเต็มบวก จะหมายถึงกราฟมีความลาดชันขึ้น

ซึ่งหากเรารู้ว่าค่าความชันเป็นจำนวนเต็มบวก เราก็ต้องลดค่า x ลง เพื่อให้เข้าใกล้ก้นรูประฆัง
แต่หากเรารู้ว่าค่าความชันเป็นจำนวนเต็มลบ เราก็ต้องเพิ่มค่า x ขึ้น เพื่อให้เข้าใกล้ก้นรูประฆังเช่นกัน
เราจึงเอาความชันนี่แหละมาประยุกใช้ในการปรับ Model


“การเอามาประยุกต์ใช้”
จากที่เรารู้ว่าสมการในการตรวจสอบความคลาดเคลื่อนของ Model ที่เรียกว่า Cost Function ซึ่งเราใช้สมการที่เรียกว่า Mean Squared Error (MSE) ที่มีหน้าตาสมการดังนี้

เราก็เอาสมการดังกล่าวมาเข้าอนุพันธ์ก็จะได้

เราก็จะได้สมการที่ใช้ในการบอกความชันแล้วครับ

หลังจากเราได้สมการความชันของ Cost Function แล้วเราก็จะเอาสมการดังกล่าวมาใช้ในการปรับค่า m และ b  ครับ

เพื่อให้เข้าใจในการทำงานมากขึ้นจะมีการทำงานของ Machine learning ดังนี้
  • ข้อมูลที่เรามีอยู่แล้ว(Feature)และรู้ผลลัพธ์อยู่แล้ว(Label)ให้ Machine learning ทำการเรียนรู้

Feature ในที่นี้พื้นที่ (m2)
Label ในที่นี้คือค่าเช่าหอต่อเดือน (บาท)
22.5
2100
24
2800
26
3250
26.5
3600
30
3800
32
4300
34.5
4600
36.5
5000
38
5800
42
7000


  • โดยในการเรียนรู้นั้นตอนแรก ML จะสร้าง Model ขึ้นมาก่อนซึ่ง Model ดังกล่าวยังไม่สามารถทำนายข้อมูลได้ถูกต้อง
    • Model ในที่นี้คือ สมการเส้นตรง y=mx+b (y คือ ราคาของห้อง, x คือ พื้นที่ของห้อง)
    • ในการสร้าง Model โดยการสุมค่า m และ b ขึ้นมา สมุติสุ่มค่า m ได้ 210 สุ่มค่า b ได้ -2600 (m=210, b=-2600)
    • ซึ่ง Model ที่เกิดจากการสุ่มค่า m และ b นั้นยังไม่สามารถทำนายข้อมูลได้ถูกต้อง


  • จึงต้องเข้าสู่กระบวนการ Train ข้อมูลเพื่อทำการปรับ Model ให้ถูกต้องมากที่สุดโดยกระบวนการ Train จะทำงานโดยการนำ Model มาทำนายผลจากข้อมูล(Feature)


    • จาก model ที่เรามีคือ y=210x-2600 (y คือ ราคาของห้อง, x คือ พื้นที่ของห้อง)
    • ทำนายราคาห้อง(y) เมื่อมีขนาดพื้นที่ห้องเป็น 22.5 ตารางเมตร (x=22.5) ดังนั้น y = 210(22.5)-2600 = 2125

  • ซึ่งก็จะมีทั้งการทำนายที่คลาดเคลื่อนกับความเป็นจริงไปมาก หรือใกล้ความเป็นจริง (ในการดูข้อมูลว่าผลทำนายที่ได้ คลาดเคลื่อนไปมากหรือใกล้ความเป็นจริงเราใช้ Cost Function ในการดู)
    • เราจะใช้ Cost Function ในการตรวจสอบความคลาด จากสมการ Cost Function ซึ่งเราจะใช้สมการที่ชื่อว่า Mean Squared Error (MSE) ในการทำ Cost function ดังนี้

    • เราเอาค่า m และ b มาแทนในสมการ

    • เราก็เอาข้อมูล Feature ที่เรามีทั้งหมดมาทำนายก็จะได้ดังนี้ครับ

    • จะเห็นว่าค่า cost function ที่ได้เป็น 1519000 

  • ก็นำเอาค่าความเคลื่อนที่ได้ ไปปรับ Model เข้าหาผลลัพธ์ที่ถูกต้อง
    • จากสมการความชันที่ทำอนุพันธ์กับสมการ Cost Function ซึ่งจะได้ดังนี้


    • จะเห็นว่าค่าความชันของ m จะมีค่าเท่ากับ -17720 ซึ่งเป็นตัวเลขติดลบแสดงว่าเราต้องบวกค่า m เพิ่มเพื่อให้ความชันใกล้ศูนย์
    • ค่าความชันของ b จะมีค่าเท่ากับ -546 ซึ่งเป็นตัวเลขติดลบแสดงว่าเราต้องบวกค่า b เพิ่มขึ้นเพื่อให้ความชันใกล้ศูนย์
    • จากค่า m และ b ใน model เดิมคือ 210 และ 2600 เราจะทำการปรับดังนี้ครับ
      • m = m – ((-17720) * LearningRate) = 210-((-17720) * 0.001) = 227.72
      • b=b-((-546)*LearningRate) = -2600-((-546)*0.001) = -2,599.454
    • จากสมการ เราจะเอาค่าที่ได้จากการคำนวณความชันที่ได้มาปรับ model หรือก็คือการปรับค่า m และ b ใหม่ จากสมการจะเห็นว่าจะมีตัวแปรหนึ่งที่ชื่อว่า LearningRate มาคูณก่อนแล้วคอยไปปรับค่า ซึ่ง LearningRate จะเป็นค่าคงที่ ในที่นี้ผมให้มีค่าเป็น 0.001 ดังนั้นค่าใหม่ที่ได้ก็จะเป็น m = 211.772 และ b = -2,599.9454

  • หลังจากนั้นจะทำการ Train ไปเรื่อยๆและปรับค่า Model ไปเรื่อยๆ(คือการปรับค่า m และ b)
  • จนใกล้เคียงข้อมูลจริงมากที่สุด
สุดท้ายนี้หวังว่าโพสน์นี้จะมีประโยชน์สำหรับแนวทางในการเริ่มต้นศึกษา Machine learning ครับและหากใครอยากทดลองเขียนโปรแกรม Linear เองสามารถดู code ได้ที่ https://github.com/CakeNuthep/Linear-Regression